0Le projet : une équipe
Dans les labos Sorti du nid et Temples Maya, chaque agent apprenait seul face à son monde. Ici, deux agents bleus jouent contre deux agents violets : chacun doit coopérer avec son coéquipier et s'adapter à des adversaires qui apprennent eux aussi. Le but : mettre le ballon dans le but adverse sans le laisser entrer dans le sien.
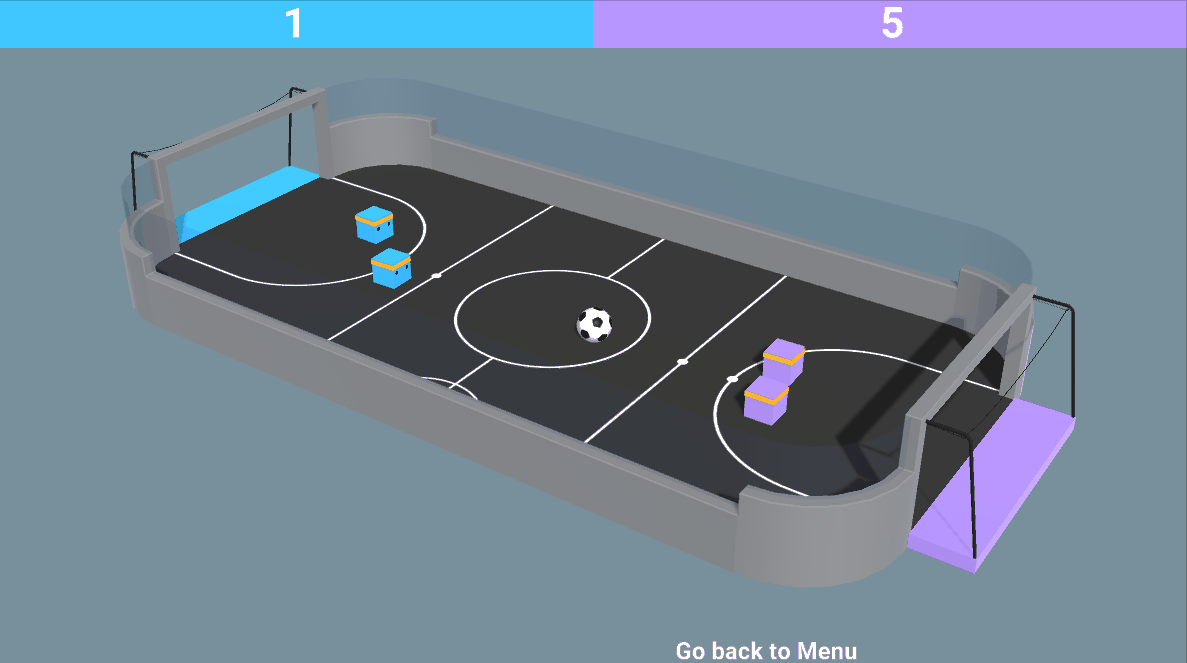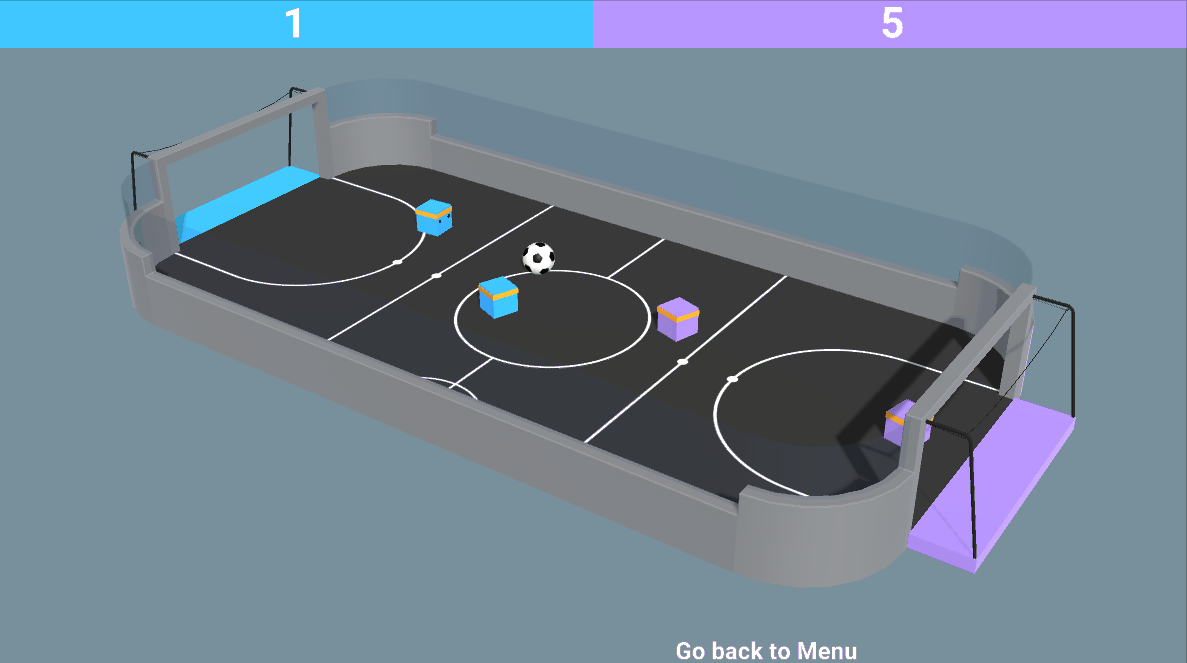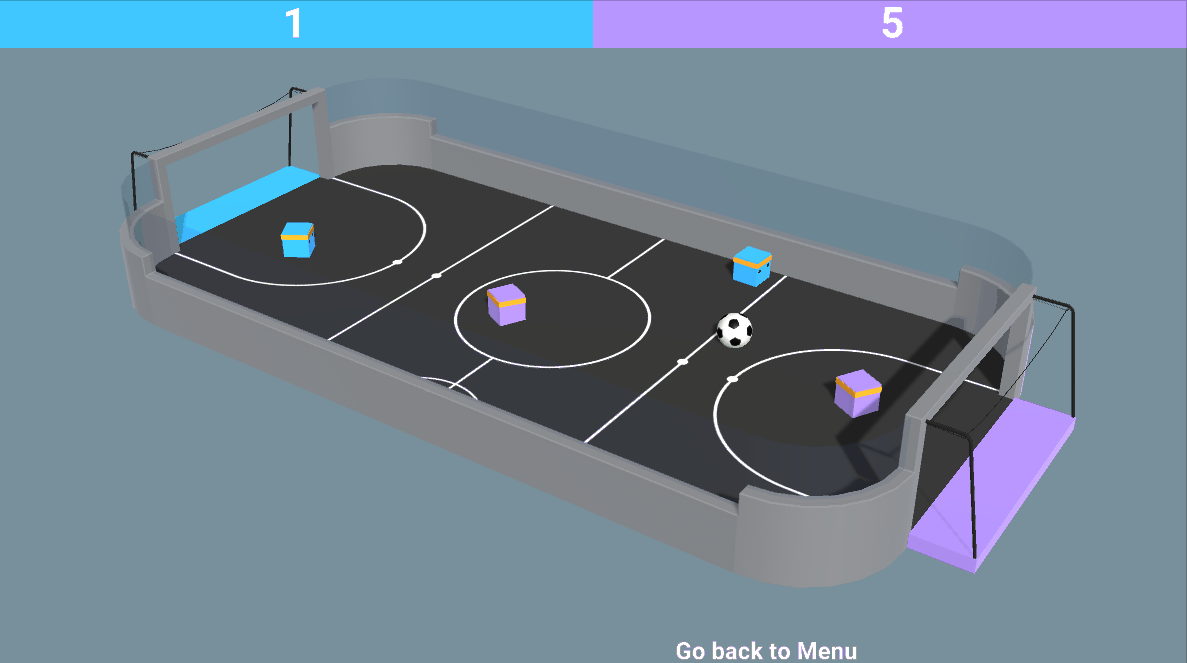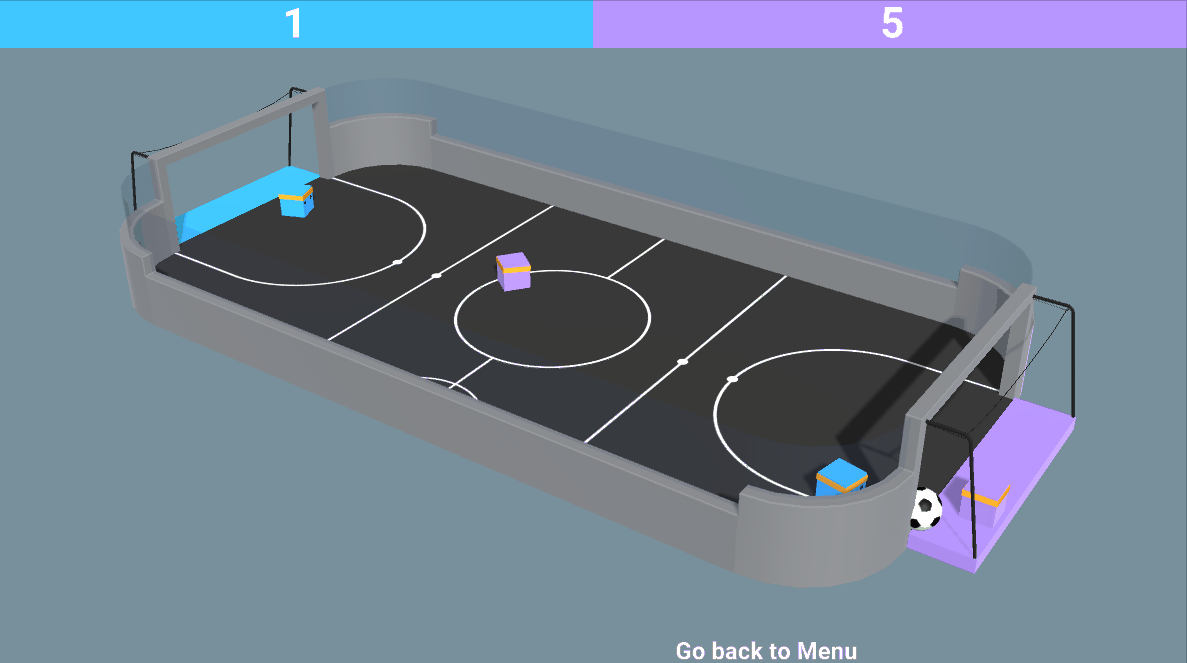
Le terrain est un exemple officiel de Unity ML-Agents. Le jeu est fourni tout compilé : pas besoin de Unity pour ce labo (sauf pour l'étape facultative finale, qui ouvre ses sources). Ce guide s'inspire de l'unité 7 du cours Deep Reinforcement Learning de Hugging Face (licence Apache 2.0), dont il reprend des images en les citant ; les commandes, les mesures et les explications sont celles de nos tests 2026.
- Installer l'environnement Python et télécharger le jeu (section 1).
- Comprendre le terrain, la récompense, les observations et les actions (section 2), puis les idées nouvelles : apprendre à plusieurs, le self-play, l'ELO et MA-POCA (section 3).
- Configurer, entraîner et suivre l'équipe (sections 4 et 5).
- Facultatif : publier son équipe sur Hugging Face (section 6).
- Facultatif : ouvrir les sources dans Unity, jouer contre son équipe et modifier le jeu (section 7).
1Installer et télécharger le jeu 2026
L'environnement Python
ML-Agents Release 23 exige Python 3.10 (ni 3.11, ni 3.12). L'entraînement se fait sur votre ordinateur : un portable ordinaire suffit, sans carte graphique.
# Le même environnement que les labos Sorti du nid et Temples Maya : s'il existe déjà, il suffit de l'activer.
# Windows (PowerShell) : remplacer python3.10 par py -3.10
python3.10 -m venv venv-ml-agents
# Linux / macOS
source venv-ml-agents/bin/activate
# Windows
venv-ml-agents\Scripts\activate

pip install "torch~=2.2.1" --index-url https://download.pytorch.org/whl/cpu
pip install "mlagents==1.1.0" "setuptools<81"

# vérification : l'aide doit s'afficher
mlagents-learn --help
Piège : sans "setuptools<81", mlagents-learn s'arrête sur
No module named 'pkg_resources'.
Le jeu et son fichier de configuration
Le jeu compilé existe en trois versions, hébergées sur ce site avec le fichier de configuration : Linux (37 Mo), Windows (30 Mo), macOS (43 Mo) et SoccerTwos.yaml. Un seul exécutable contient 8 terrains : 16 parties en même temps pour apprendre plus vite.
mkdir labo-soccer
cd labo-soccer
curl -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/soccer-twos-linux.zip
curl -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/SoccerTwos.yaml
unzip soccer-twos-linux.zip -d SoccerTwos
chmod +x SoccerTwos/SoccerTwos.x86_64mkdir labo-soccer
cd labo-soccer
curl.exe -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/soccer-twos-windows.zip
curl.exe -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/SoccerTwos.yaml
Expand-Archive soccer-twos-windows.zip -DestinationPath .
# le jeu est maintenant dans SoccerTwos\SoccerTwos.exemkdir labo-soccer
cd labo-soccer
curl -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/soccer-twos-mac.zip
curl -LO https://intelligence.projet.autos/labo-agents/guide-equipe-soccer/executables/SoccerTwos.yaml
unzip soccer-twos-mac.zip -x "__MACOSX/*"
# macOS bloque les applications téléchargées : retirer la quarantaine
xattr -cr SoccerTwos.appAttendu : dans labo-soccer, le fichier SoccerTwos.yaml et le
jeu (SoccerTwos/SoccerTwos.x86_64, SoccerTwos\SoccerTwos.exe ou SoccerTwos.app).
2Le terrain, la récompense, les observations et les actions
La récompense : une affaire d'équipe
Quand le ballon entre dans le but adverse, l'équipe qui marque reçoit 1 moins une pénalité de temps (marquer vite vaut plus) ; l'autre équipe reçoit -1. La récompense est donnée au groupe, pas à un joueur : les deux coéquipiers la reçoivent, même si un seul a touché le ballon.
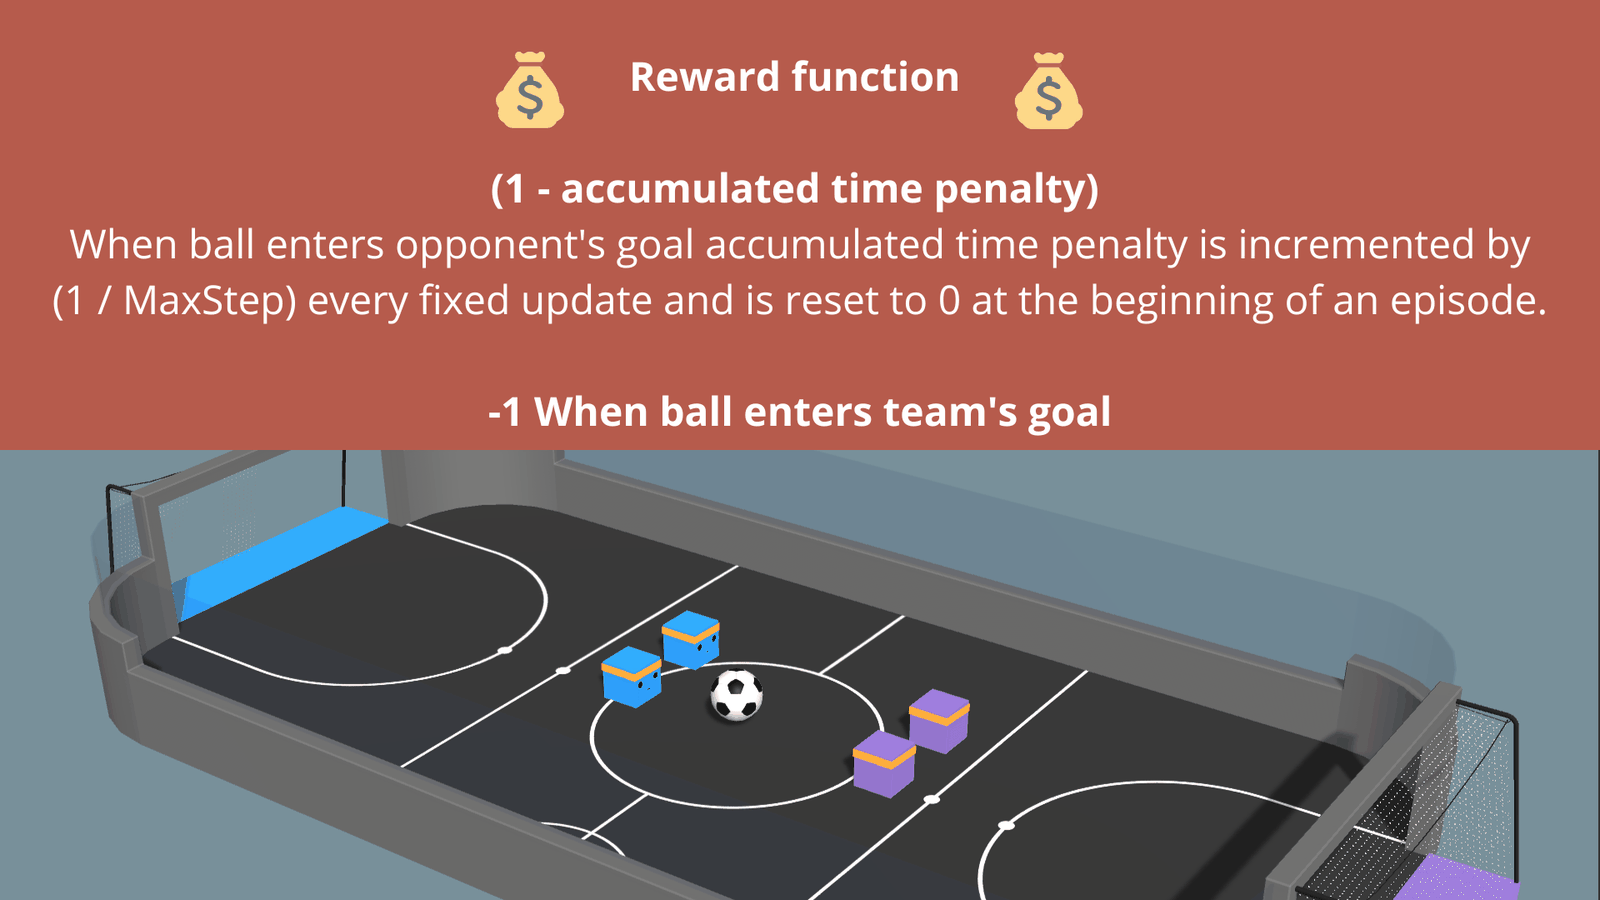
    public void GoalTouched(Team scoredTeam)
    {
        if (scoredTeam == Team.Blue)
        {
            m_BlueAgentGroup.AddGroupReward(1 - (float)m_ResetTimer / MaxEnvironmentSteps);
            m_PurpleAgentGroup.AddGroupReward(-1);
        }
        else
        {
            m_PurpleAgentGroup.AddGroupReward(1 - (float)m_ResetTimer / MaxEnvironmentSteps);
            m_BlueAgentGroup.AddGroupReward(-1);
        }
        m_PurpleAgentGroup.EndGroupEpisode();
        m_BlueAgentGroup.EndGroupEpisode();
        ResetScene();
    }
Ce que voit un joueur
Chaque joueur perçoit le terrain par des rayons (comme les capteurs à rayons des labos précédents) : 11 rayons vers l'avant sur 120 degrés et 3 vers l'arrière sur 90 degrés. Chaque rayon dit ce qu'il touche parmi 6 choses (le ballon, le but bleu, le but violet, un mur, un joueur bleu, un joueur violet) et à quelle distance. Avec les trois dernières observations empilées, cela fait 336 nombres à chaque décision (264 pour l'avant, 72 pour l'arrière). Un joueur ne voit donc ni le score, ni la position exacte des autres : seulement ses rayons.
Ce que peut faire un joueur
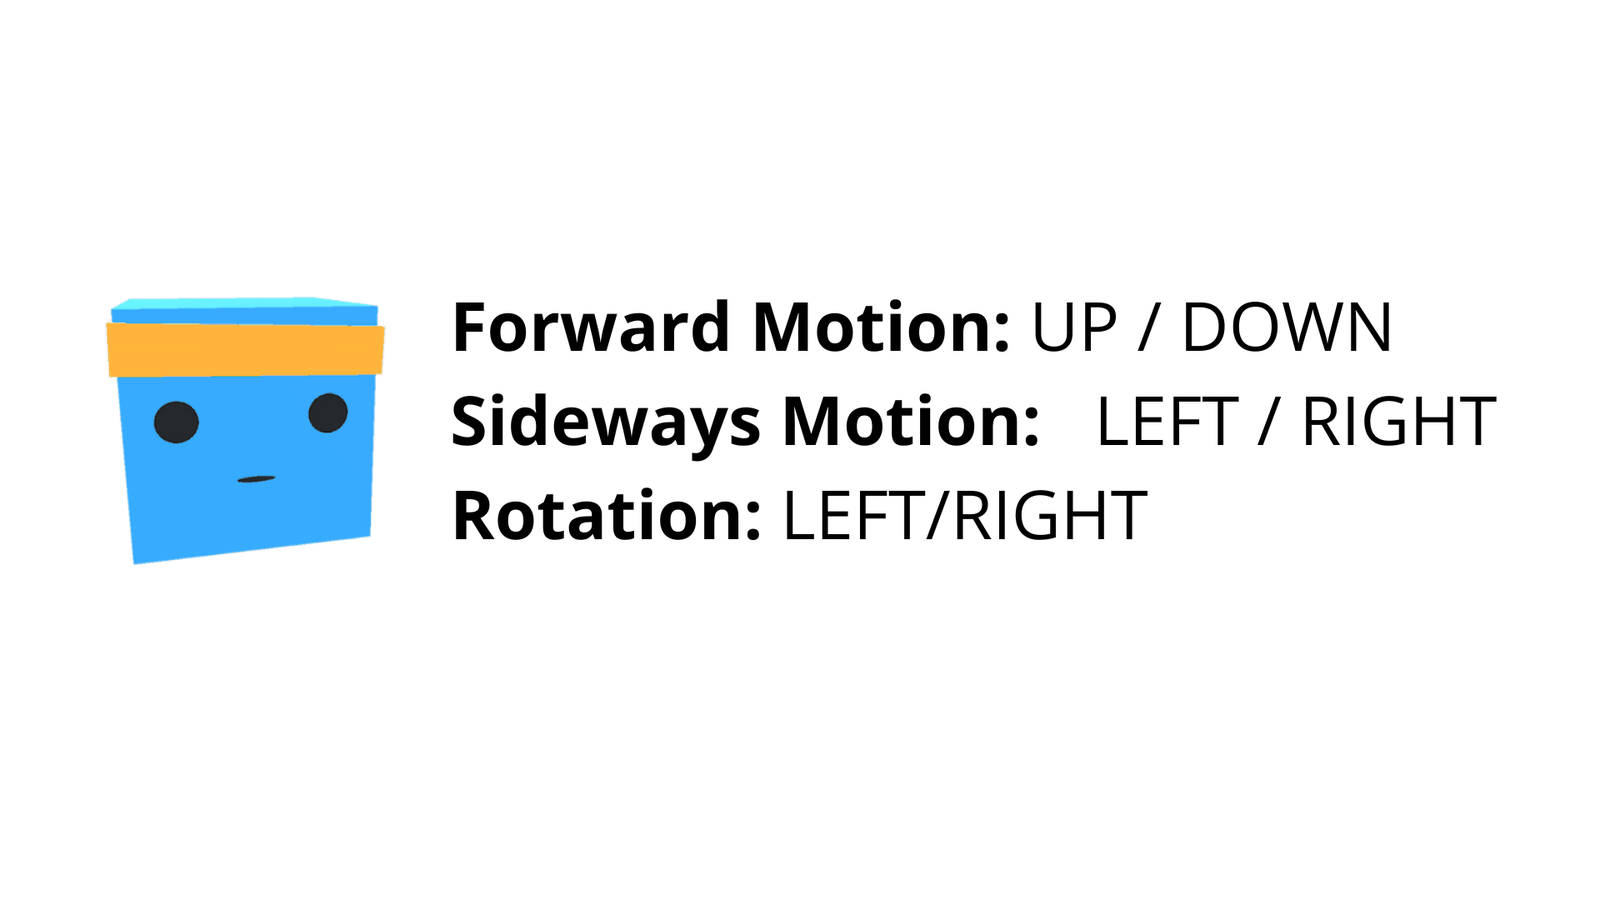
    public override void Heuristic(in ActionBuffers actionsOut)
    {
        var discreteActionsOut = actionsOut.DiscreteActions;
        //forward
        if (Input.GetKey(KeyCode.W))
        {
            discreteActionsOut[0] = 1;
        }
        if (Input.GetKey(KeyCode.S))
        {
            discreteActionsOut[0] = 2;
        }
        //rotate
        if (Input.GetKey(KeyCode.A))
        {
            discreteActionsOut[2] = 1;
        }
        if (Input.GetKey(KeyCode.D))
        {
            discreteActionsOut[2] = 2;
        }
        //right
        if (Input.GetKey(KeyCode.E))
        {
            discreteActionsOut[1] = 1;
        }
        if (Input.GetKey(KeyCode.Q))
        {
            discreteActionsOut[1] = 2;
        }
}3Apprendre à plusieurs : self-play, ELO et MA-POCA
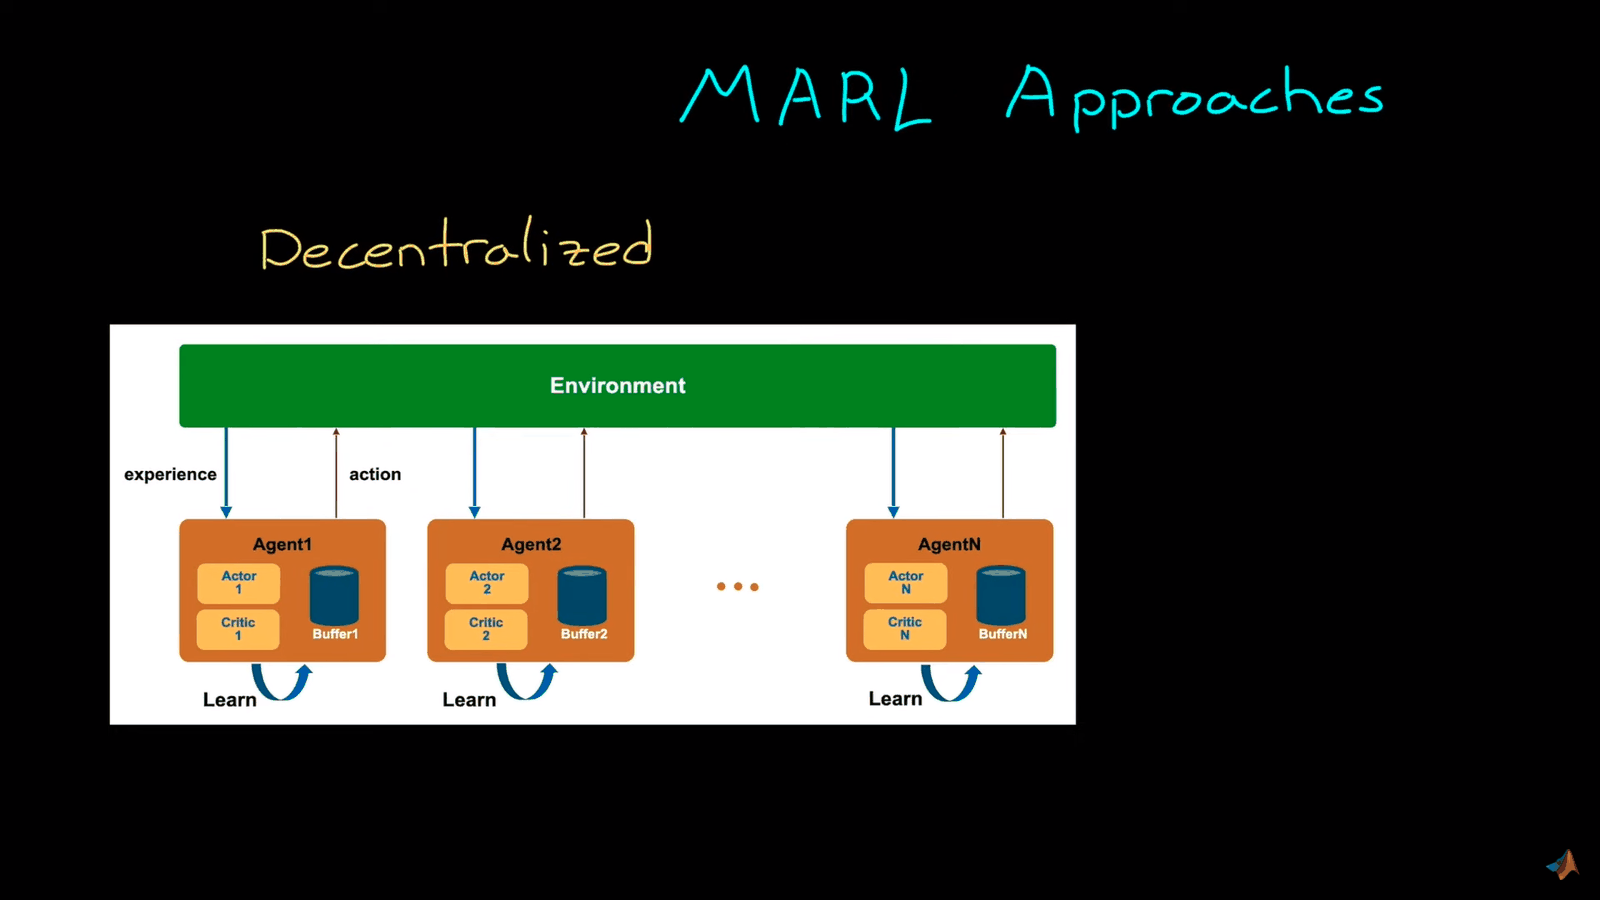
Chacun pour soi, ou tous ensemble ?
Il y a deux grandes façons d'entraîner plusieurs agents. Décentralisée : chaque agent apprend seul et voit les autres comme une partie du décor. C'est simple, mais le décor change sans cesse (les autres apprennent aussi), ce qui déstabilise l'apprentissage.
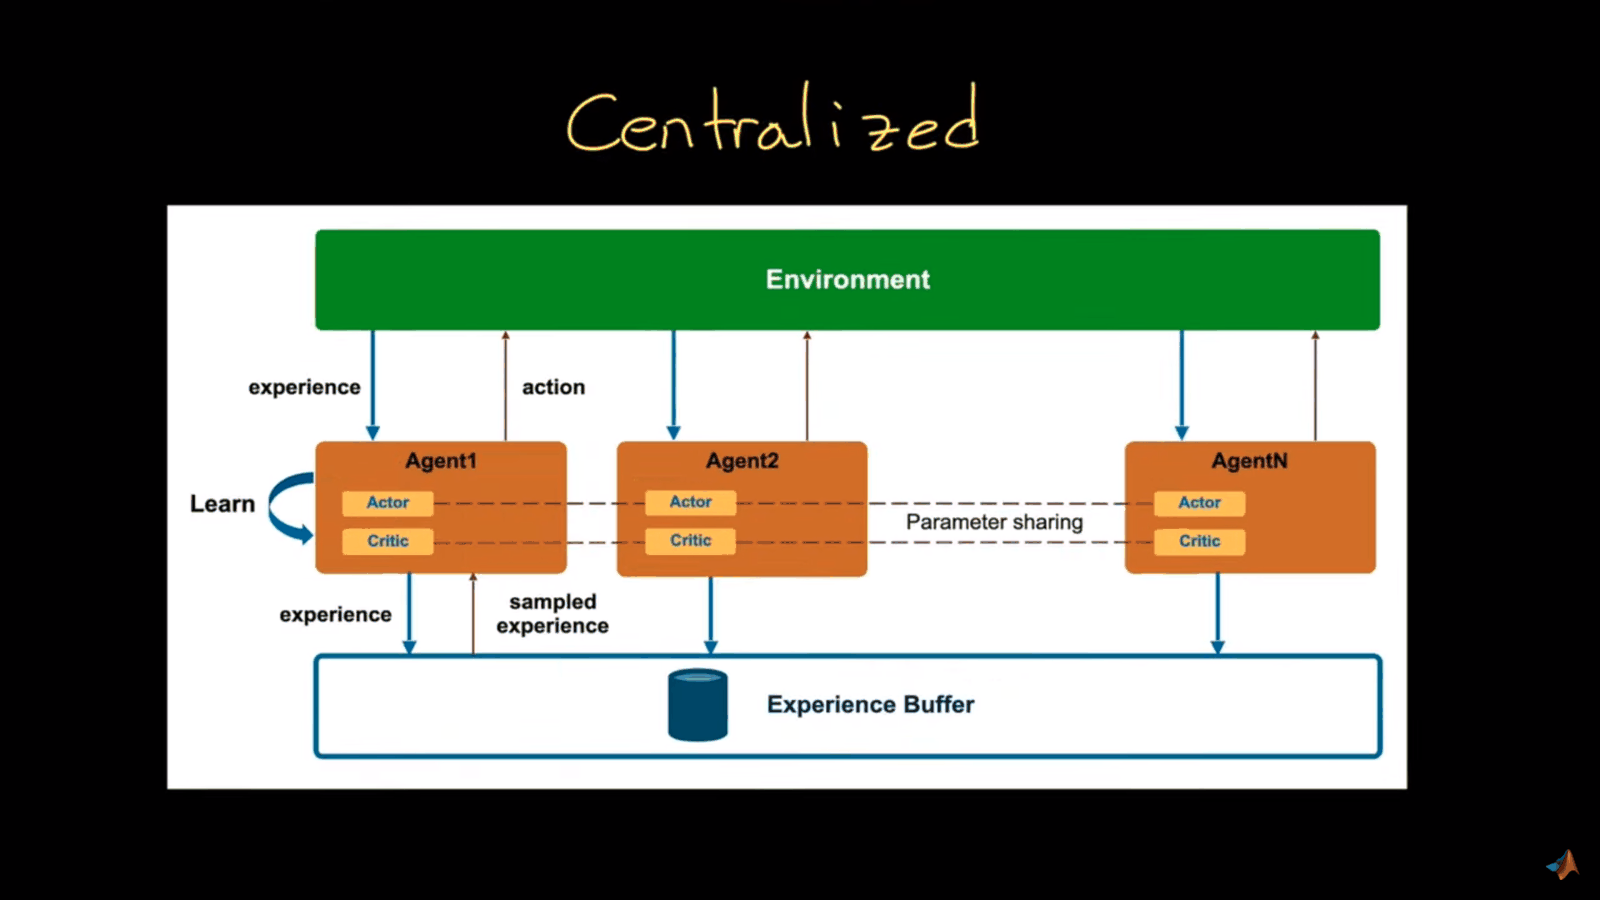
Centralisée : un processus commun rassemble les expériences de tous et apprend une politique pour le groupe. L'environnement redevient stable, mais tout passe par un seul cerveau.
Le self-play : jouer contre soi-même
Contre qui s'entraîner ? Un adversaire trop fort, et l'équipe perd tout le temps sans rien apprendre ; trop faible, et elle apprend des trucs qui ne marcheront jamais contre un vrai adversaire. La solution : jouer contre d'anciennes copies de soi-même. L'adversaire a toujours à peu près le même niveau, et il progresse avec l'équipe. C'est le self-play, déjà utilisé dans les années 1950 pour les dames et en 1995 pour le backgammon (TD-Gammon).
L'ELO : mesurer sans récompense absolue
En self-play, la récompense ne dit plus rien : quand on joue contre soi, on gagne à peu près autant qu'on perd, et la récompense d'équipe reste autour de 0 même si l'équipe devient excellente. On mesure donc le niveau relatif, avec le classement ELO des échecs : tout le monde part à 1200 ; après chaque partie, le gagnant prend des points au perdant, beaucoup s'il était donné perdant, peu s'il était favori.
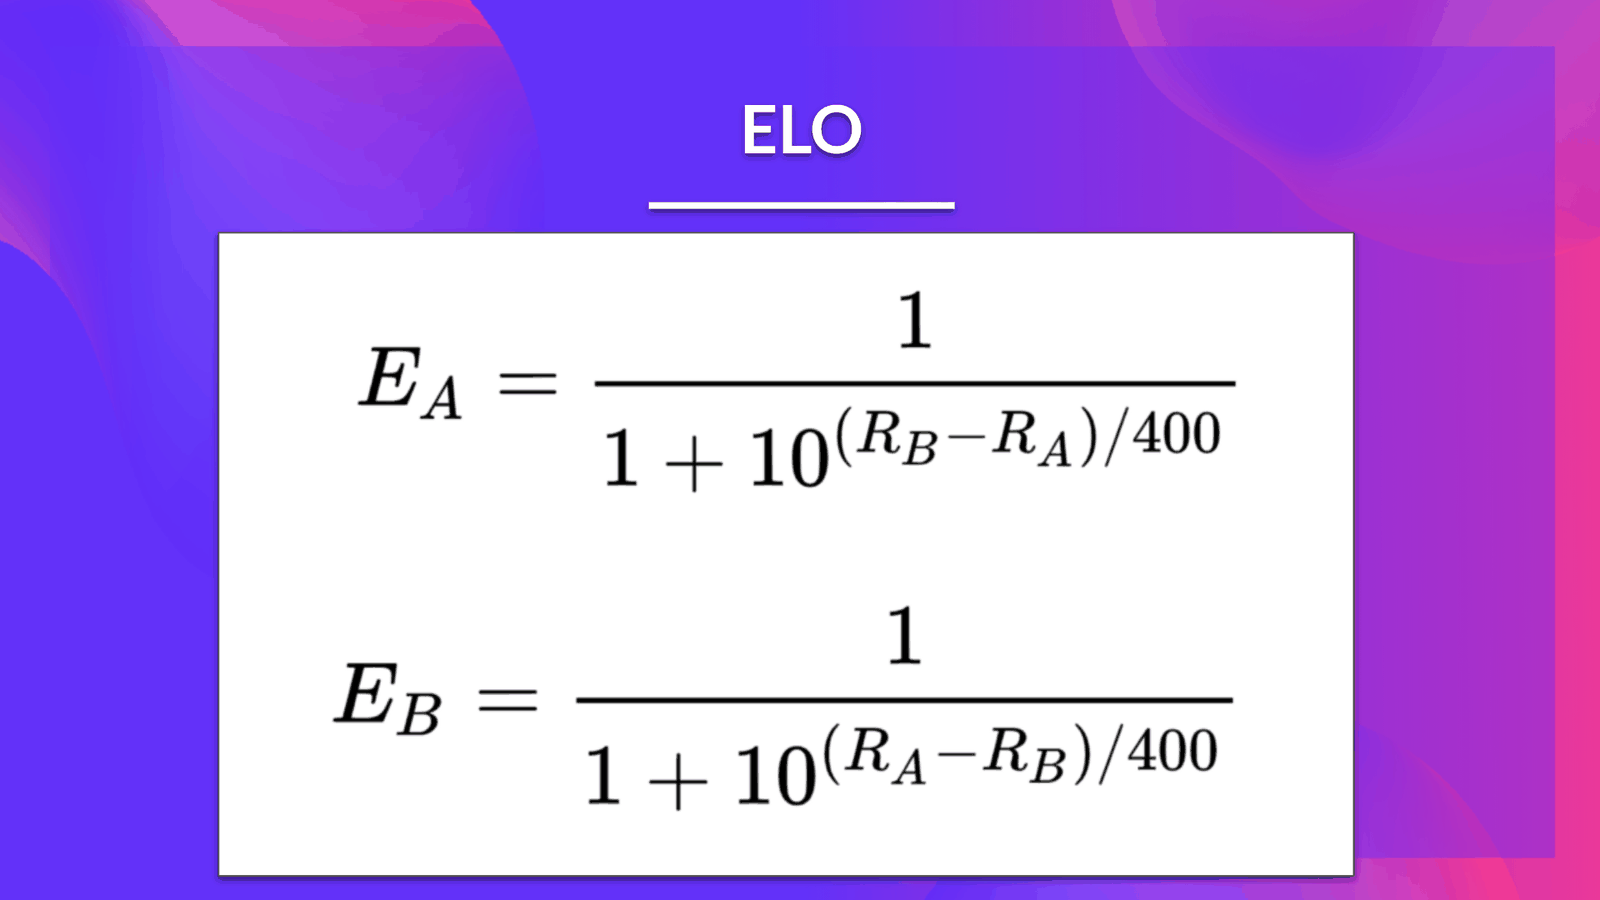
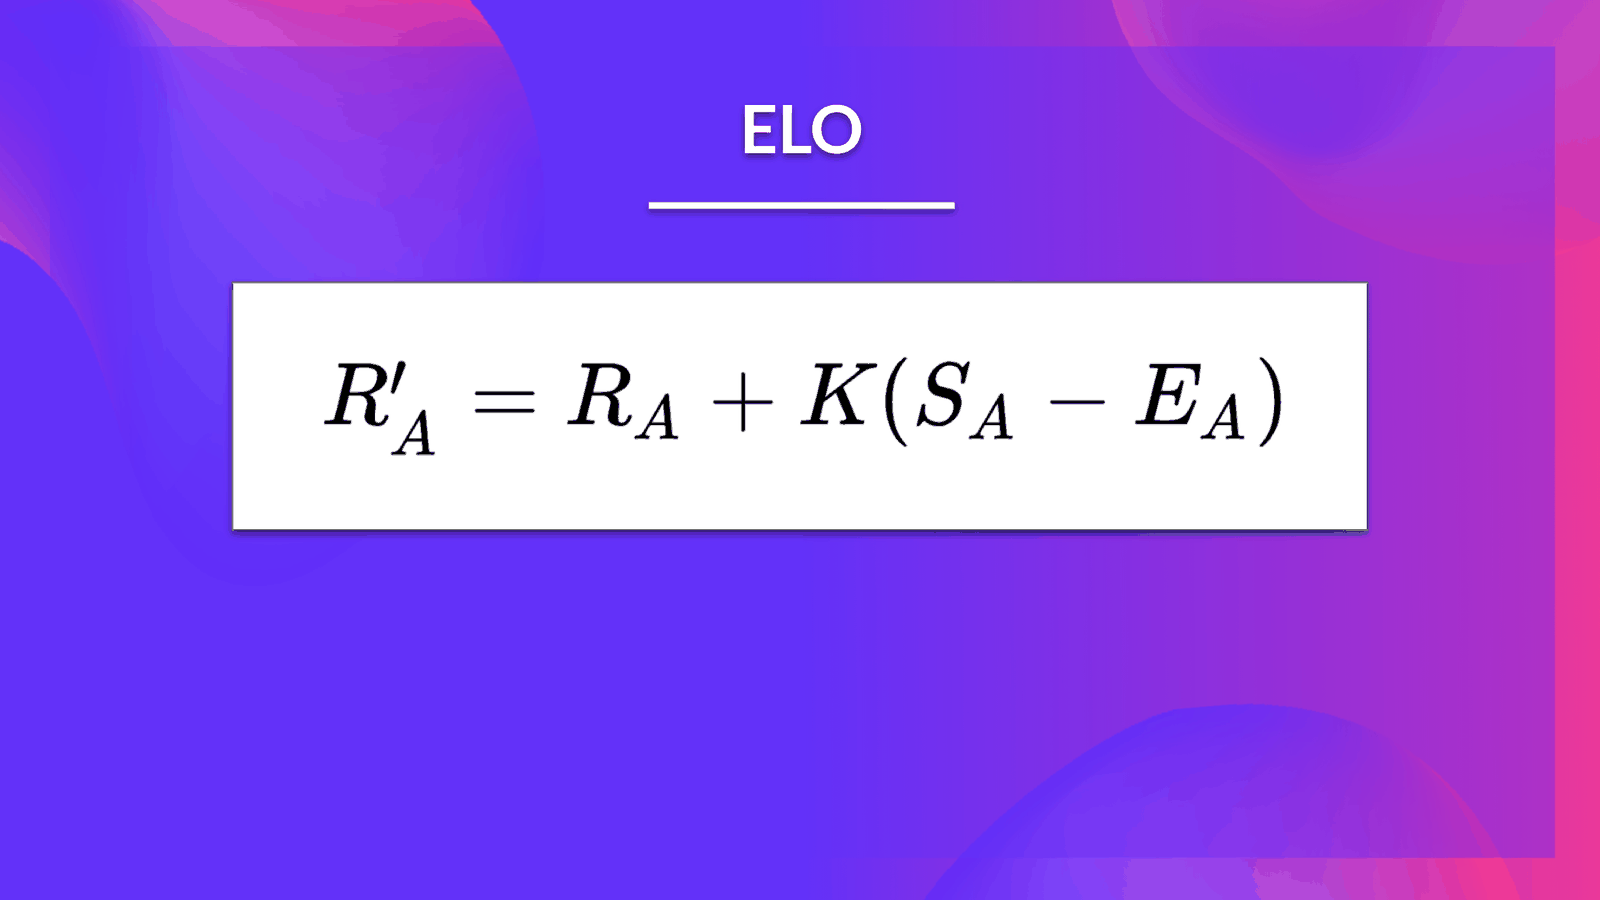
Exemple : A a 2600, B a 2300. Le score attendu de A vaut 1 / (1 + 10(2300 - 2600) / 400) = 0,85 : A est favori. Si B gagne quand même, avec K = 16, B gagne 16 x (1 - 0,15) = 13,6 points (2313,6) et A en perd autant (2586,4). Une victoire surprise rapporte gros.
MA-POCA : un entraîneur pour l'équipe
Reste un problème : la récompense est donnée à toute l'équipe. Si un seul joueur a fait le bon geste, comment l'autre sait-il qu'il n'y était pour rien ? L'algorithme MA-POCA (Multi-Agent POsthumous Credit Assignment) ajoute un critique centralisé qui regarde l'état de tous les joueurs de l'équipe et estime l'apport de chacun : un entraîneur. Pendant la partie, chaque joueur décide seul avec ses rayons ; pendant l'apprentissage, l'entraîneur répartit le mérite.
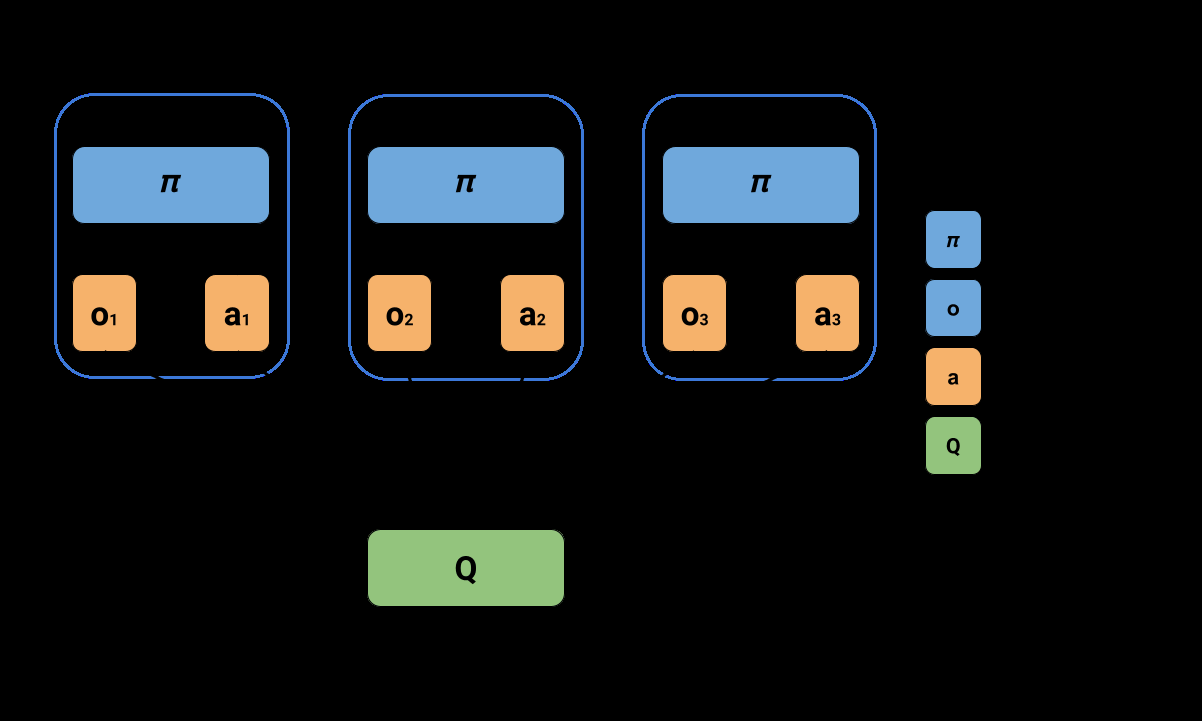
Le « Credit Assignment » de MA-POCA est l'attribution du mérite, déjà rencontrée au labo Temples Maya, quand Indie n'osait pas traverser le feu : ici, le mérite se partage entre coéquipiers.
4Le fichier de configuration
SoccerTwos.yaml ressemble à ceux des labos précédents, avec deux nouveautés :
trainer_type: poca (MA-POCA au lieu de PPO) et une section self_play.
behaviors:
  SoccerTwos:
    trainer_type: poca
    hyperparameters:
      batch_size: 2048
      buffer_size: 20480
      learning_rate: 0.0003
      beta: 0.005
      epsilon: 0.2
      lambd: 0.95
      num_epoch: 3
      learning_rate_schedule: constant
    network_settings:
      normalize: false
      hidden_units: 512
      num_layers: 2
      vis_encode_type: simple
    reward_signals:
      extrinsic:
        gamma: 0.99
        strength: 1.0
    keep_checkpoints: 5
    max_steps: 3000000
    time_horizon: 1000
    summary_freq: 10000
    self_play:
      save_steps: 50000
      team_change: 200000
      swap_steps: 2000
      window: 10
      play_against_latest_model_ratio: 0.5
initial_elo: 1200.0| Réglage de self_play | Ce qu'il décide |
|---|---|
save_steps: 50000 | Tous les 50 000 pas, une copie de l'équipe est mise de côté comme futur adversaire. |
window: 10 | On garde les 10 dernières copies : plus la fenêtre est grande, plus les adversaires sont variés. |
play_against_latest_model_ratio: 0.5 | Une partie sur deux contre la version la plus récente, l'autre contre une copie au hasard dans la fenêtre. |
swap_steps: 2000 | On change d'adversaire tous les 2000 pas. |
team_change: 200000 | Tous les 200 000 pas, l'équipe qui apprend change de côté (bleu ou violet). |
initial_elo: 1200.0 | L'ELO de départ. |
Le compromis : des adversaires qui changent lentement donnent un apprentissage stable, mais l'équipe risque de ne savoir battre qu'eux ; des adversaires variés donnent une équipe plus polyvalente, plus lentement.
5Entraîner et suivre l'équipe
Dans le dossier labo-soccer, venv activé :
mlagents-learn SoccerTwos.yaml --env=SoccerTwos/SoccerTwos.x86_64 --run-id=soccer1 --no-graphicsmlagents-learn SoccerTwos.yaml --env=SoccerTwos\SoccerTwos.exe --run-id=soccer1 --no-graphicsmlagents-learn SoccerTwos.yaml --env=SoccerTwos.app --run-id=soccer1 --no-graphics# dans un deuxième terminal, venv activé, dans le dossier labo-soccer
tensorboard --logdir results
# puis ouvrir http://localhost:6006 dans le navigateurPiège : pour arrêter avant la fin, faire Ctrl+C une seule fois et attendre :
ML-Agents écrit le cerveau results/soccer1/SoccerTwos.onnx avant de fermer. Deux Ctrl+C coupent tout sans
cerveau. Désactiver aussi la mise en veille de l'ordinateur pendant l'entraînement.
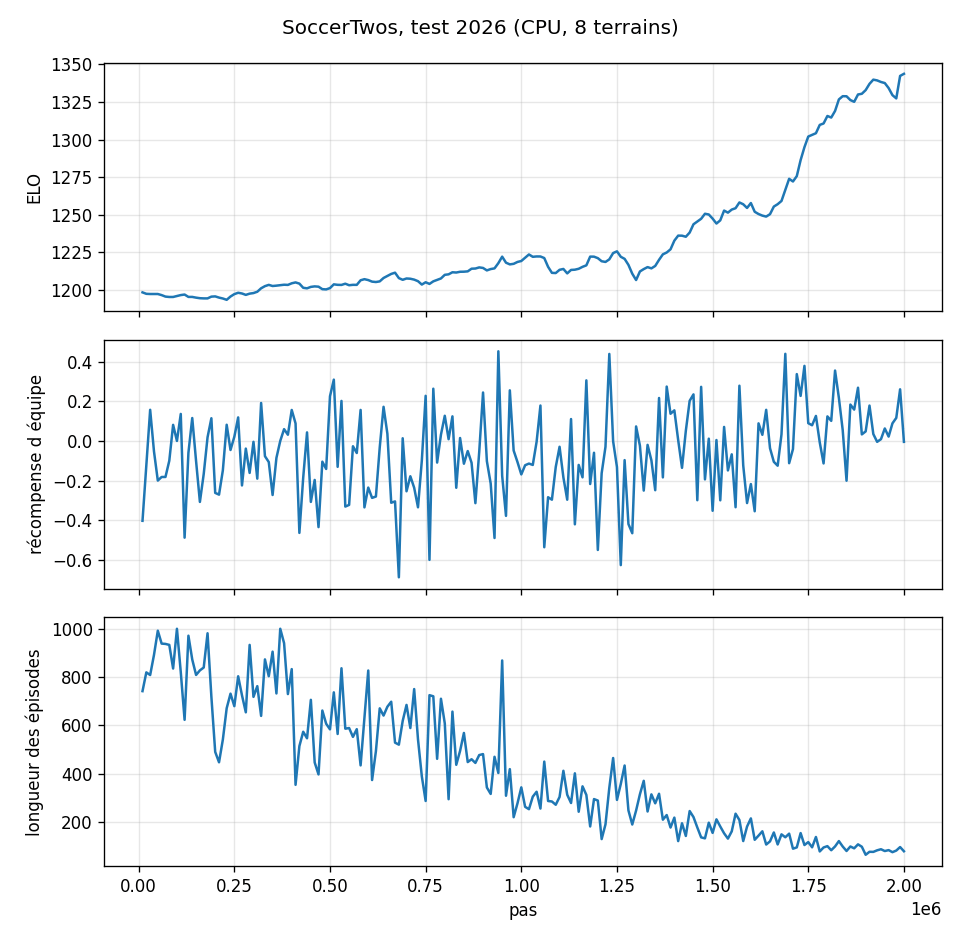
Mesuré avec ce guide : 2 millions de pas en 2 h 23 sur un portable à 4 coeurs sans carte graphique (8 terrains) ; l'ELO reste presque plat jusqu'à 1,4 million de pas (1198 à 1230), puis monte à 1344 à 2 millions ; la durée des parties passe d'environ 750 décisions à 80 : les buts arrivent vite. Avant 1,5 million de pas, il est normal de ne rien voir : les joueurs errent sur le terrain avant de savoir marquer.
6Facultatif : publier son équipe sur Hugging Face
- Se créer un compte sur huggingface.co et confirmer son courriel.
- Dans Settings > Access Tokens, créer un jeton de type Write et le copier.
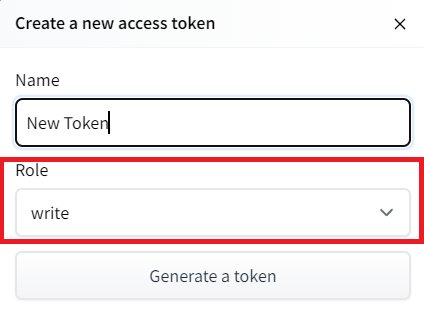
# 1. se connecter (coller le jeton « Write » quand il est demandé)
hf auth login

# 2. publier : remplacer VOTRE-NOM par votre nom d'utilisateur Hugging Face
mlagents-push-to-hf --run-id=soccer1 --local-dir=results/soccer1 --repo-id=VOTRE-NOM/poca-SoccerTwos --commit-message="Premier envoi"
Attendu : le terminal affiche l'adresse de votre modèle
(https://huggingface.co/VOTRE-NOM/poca-SoccerTwos). C'est un dépôt Git : un nouvel envoi crée une
nouvelle version. La page du modèle contient votre configuration, vos courbes TensorBoard et le cerveau.
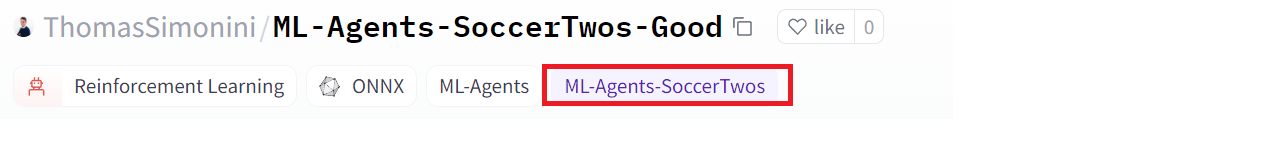
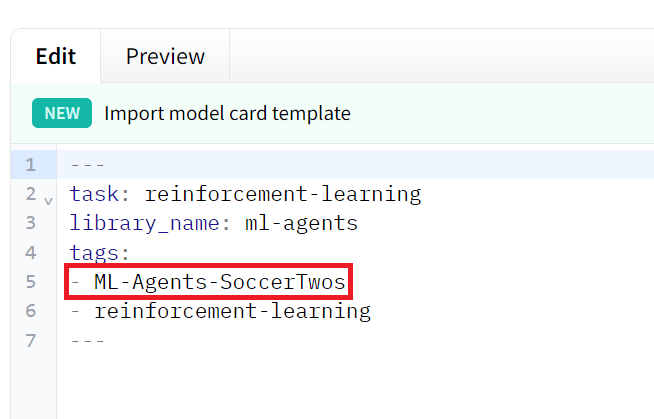
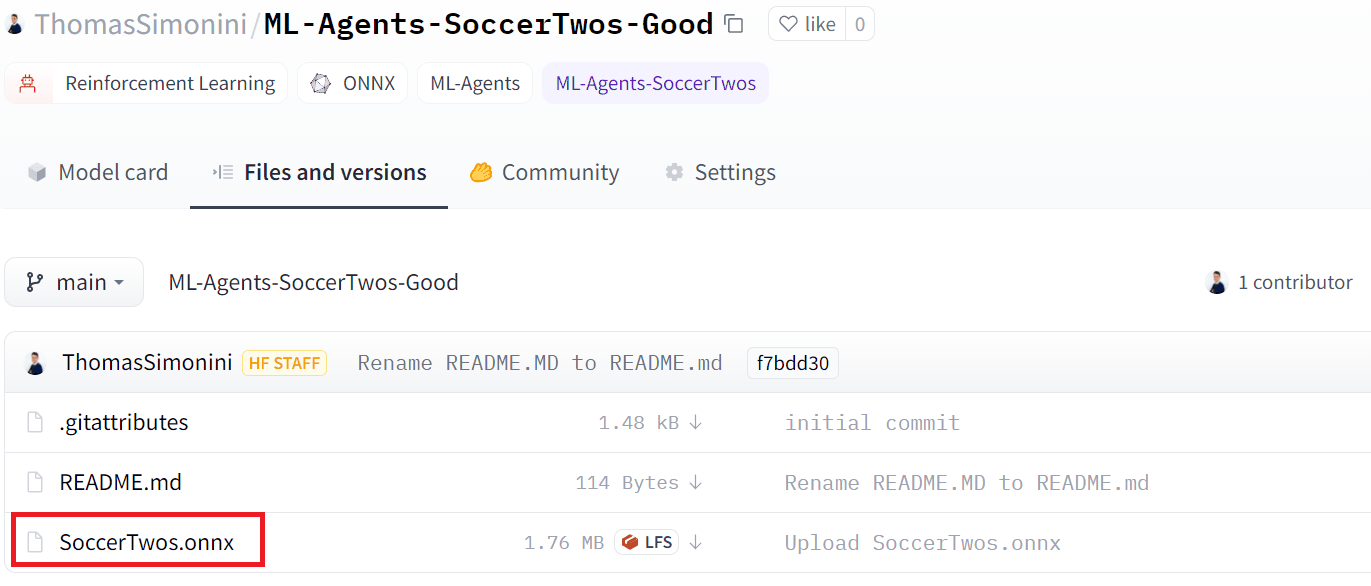
Vérifier sur la page du modèle que l'étiquette ML-Agents-SoccerTwos est présente (sinon, l'ajouter
dans le README) et que le fichier SoccerTwos.onnx est là :
Le classement « AI vs AI » qui faisait jouer les modèles publiés les uns contre les autres ne
fonctionne plus depuis la fin de 2024. Vos équipes se rencontreront dans
la ligue de la classe (classement ELO) : gardez votre SoccerTwos.onnx.
7Facultatif : ouvrir les sources, jouer et modifier le jeu 2026
Le jeu compilé vient d'un projet Unity dont les sources sont publiques : on peut y faire jouer votre équipe, la défier au clavier, et changer le jeu. Il faut Unity 6.3 LTS (6000.3.x : dans le Unity Hub, la ligne marquée LTS, et non la ligne « Recommended » Unity 6.6).
Ouvrir le projet
git clone --branch release_23 --depth 1 https://github.com/Unity-Technologies/ml-agents.git
# le projet Unity des exemples est dans ml-agents/Project- Hub > Add > Add project from disk > le dossier
ml-agents/Project. L'ouvrir avec 6000.3 et accepter la mise à jour (la première ouverture est longue). - Project :
Assets/ML-Agents/Examples/Soccer/Scenes/SoccerTwos, double-clic. - Glisser votre
results/soccer1/SoccerTwos.onnxdans le dossierAssets.
Faire jouer votre équipe
- Dans la Hierarchy, la scène contient 8 terrains (
SoccerFieldTwosàSoccerFieldTwos (7)). Décocher les terrains (1) à (7) : un seul terrain en Play (voir le piège ci-dessous). - Dans
SoccerFieldTwos, sélectionner les quatre joueurs (BlueStriker,BlueStriker (1),PurpleStriker,PurpleStriker (1)). Dans Behavior Parameters : Model = votreSoccerTwos, Behavior Type = Inference Only, Inference Device = Burst (le processeur). - Play : votre équipe joue contre elle-même.
Piège : avec plusieurs terrains en inférence, ML-Agents 4.0 peut ne faire bouger qu'une partie des agents qui partagent un cerveau (constaté au labo Sorti du nid). Un seul terrain : les quatre joueurs jouent (vérifié pour ce guide).
Jouer contre votre équipe
Sur un des joueurs bleus, mettre Behavior Type = Heuristic Only : c'est vous qui le dirigez
(W/S avancer et reculer, A/D tourner, Q/E de côté, la fonction Heuristic de la section 2). Votre
coéquipier et les deux violets restent pilotés par votre cerveau.
Modifier le jeu : remplacer les joueurs
Un joueur est fait de deux parties. L'objet BlueStriker porte tout ce qui compte pour le cerveau : le
tag blueAgent, le collider, le rigidbody et les scripts. Son enfant AgentCube_Blue n'est que
son apparence. On peut donc changer l'apparence sans toucher au cerveau :
- Dans le prefab
SoccerFieldTwos, sousBlueStriker, décocherAgentCube_Blue. - Ajouter à la place, comme enfant de
BlueStriker, votre modèle 3D (un personnage importé, ou GameObject > 3D Object > Capsule), et retirer son collider : seul celui du parent doit compter. - Même chose pour les trois autres joueurs, puis Play.
Ce qu'on peut changer, et ce qu'on ne peut pas : l'apparence, les couleurs, le décor, oui. Mais le cerveau a été entraîné avec 336 observations (les rayons et leurs 6 tags) et 3 branches d'actions : changer les rayons, les tags ou les actions le rend incompatible. Changer la taille du terrain, la masse du ballon ou la vitesse des joueurs est permis, et c'est une belle expérience : votre équipe tient-elle le coup dans un monde un peu différent de celui où elle a appris ?
8Remise
- Le fichier de configuration
SoccerTwos.yamlutilisé. - Le cerveau
results/soccer1/SoccerTwos.onnx. - (Facultatif) Le lien de votre modèle sur Hugging Face.
- Une capture TensorBoard des courbes Self-play / ELO et Environment / Episode Length, avec une phrase : pourquoi la récompense d'équipe reste-t-elle autour de 0 alors que votre équipe progresse ?
9Dépannage
| Symptôme | Cause et remède |
|---|---|
No module named 'pkg_resources' | pip install "setuptools<81" dans le venv. |
Address already in use | Un autre entraînement occupe le port 5004 : ajouter --base-port=5105 à la commande. |
| macOS : « SoccerTwos.app est endommagé » | La quarantaine des fichiers téléchargés : xattr -cr SoccerTwos.app. |
Linux : Permission denied au lancement | chmod +x SoccerTwos/SoccerTwos.x86_64. |
| L'ELO ne bouge pas (ou descend sous 1200) | Normal avant 1,5 à 2 millions de pas : patience. |
Pas de SoccerTwos.onnx après un arrêt | Deux Ctrl+C : relancer la même commande avec --resume, puis un seul Ctrl+C. |
| Le message « communication version 1.5.0 » | Le jeu compilé date de 2023 : il fonctionne avec ML-Agents Release 23, l'avertissement est sans effet. |
| Unity : un seul joueur bouge en Play | Plusieurs terrains actifs en inférence : n'en garder qu'un (section 7). |
10Crédits
- L'environnement SoccerTwos, ses exécutables et son fichier de configuration : Unity ML-Agents, licence Apache 2.0, © 2017 Unity Technologies.
- Les images citées : le cours Deep Reinforcement Learning de Hugging Face (dépôt du cours, licence Apache 2.0).
- Le texte, les commandes, les mesures, les courbes et les vidéos : ce guide, 2026.
Retour à l'énoncé du labo Équipe Soccer · environnement : Unity ML-Agents (Apache 2.0) · images citées : cours Deep RL de Hugging Face (Apache 2.0).