0Le projet en trois activités
L'intro du projet, avec la vidéo de l'agent entraîné et les liens d'origine, est le diaporama Aventure Maya, un projet ML-Agent. Ce guide est la partie technique : tout ce qu'il faut pour faire les trois activités en 2026, avec Unity 6 LTS et ML-Agents Release 23. Les endroits qui ont changé depuis le cours d'origine (Thomas Simonini, 2020-2021) portent la pastille 2026.
- Le cube sauteur de mur (WallJump) : un exemple officiel de ML-Agents. On l'entraîne tel quel pour apprendre la mécanique : lancer, suivre, arrêter, lire les courbes. Deux cerveaux pour un même agent.
- Les pyramides (Pyramids) : l'agent doit trouver un bouton, faire apparaître une pyramide, la renverser et prendre la brique d'or. La récompense est trop rare : on ajoute la curiosité.
- L'Aventure Maya : Indie traverse des ponts de bois et du feu jusqu'à la statue d'or, en se transformant en roche ou en bois. On entraîne avec un curriculum : les niveaux s'ajoutent à mesure que l'agent réussit.
Ce qui a changé depuis 2020, en une phrase : les cerveaux sont maintenant des fichiers .onnx
(les .nn du cours ne se lisent plus), le yaml a changé de format, et le code des agents utilise
ActionBuffers. Les cerveaux pré-entraînés fournis avec l'Aventure Maya ne peuvent donc plus être testés :
on entraîne le sien.
1Installer les outils 2026
Unity 6 LTS
Par le Unity Hub (compte Unity, licence Personal gratuite) : Installs > Install Editor > la ligne marquée LTS, soit Unity 6.3 LTS (6000.3.x), et non la ligne marquée « Recommended » (Unity 6.6, 6000.6.x) : le Hub recommande maintenant une version plus récente, mais ce guide a été vérifié avec 6000.3.
Python 3.10.12 et ML-Agents
ML-Agents Release 23 exige Python 3.10 (ni 3.11, ni 3.12). Environnement virtuel, puis :
# Windows (PowerShell) : remplacer python3.10 par py -3.10
python3.10 -m venv venv-colibri
# Linux / macOS
source venv-colibri/bin/activate
# Windows
venv-colibri\Scripts\activate

# torch en version processeur (aucune carte graphique nécessaire : l'entraînement du colibri tient sur un CPU)
pip install "torch~=2.2.1" --index-url https://download.pytorch.org/whl/cpu
pip install "mlagents==1.1.0" "setuptools<81"

# vérification : l'aide doit s'afficher
mlagents-learn --help
Piège : sans "setuptools<81", mlagents-learn s'arrête sur
No module named 'pkg_resources'.
Le dépôt ML-Agents (pour les activités 1 et 2)
git clone --branch release_23 --depth 1 https://github.com/Unity-Technologies/ml-agents.gitDans le Hub : Add > Add project from disk > le dossier ml-agents/Project.
Le projet a été créé avec Unity 6000.0 : l'ouvrir avec 6000.3 et accepter la mise à jour. La première ouverture est longue.
2Activité 1 : le cube sauteur de mur
Lecture recommandée : An introduction to Unity ML-Agents (Simonini, 2020, copie archivée).
Ce que l'agent doit apprendre
- Pas de mur : atteindre le carré vert.
- Petit mur : sauter par-dessus.
- Grand mur : pousser le bloc blanc contre le mur, monter dessus, sauter.
Un seul agent, mais deux cerveaux : SmallWallJump (pas de mur ou petit mur) et
BigWallJump (grand mur). Le script de l'agent change de cerveau selon le mur qui apparaît.
Préparer l'entraînement
- Dans le Project :
Assets/ML-Agents/Examples/WallJump/Scenes/WallJump, double-clic. - Ouvrir le prefab
WallJumpArea> l'enfantAgent. Dans Behavior Parameters, vider Model. Dans Wall Jump Agent, vider les trois cerveaux (No Wall, Small Wall, Big Wall). - Le fichier de configuration existe déjà :
ml-agents/config/ppo/WallJump.yaml.
# venv activé, depuis le dossier ml-agents cloné
mlagents-learn config/ppo/WallJump.yaml --run-id=murs1
# puis Play dans Unity
Mesuré avec ce guide : petit mur de -0,9 à 0,68 en 180 000 pas : l'agent saute le petit mur ; grand mur de -1,1 à -0,7 en 600 000 pas : le grand mur (pousser le bloc, monter, sauter) demande plusieurs millions de pas
(1 h 20 sur un portable à 4 coeurs sans carte graphique, une seule aire, en partageant le processeur avec un autre calcul). Le cours de 2020 visait 300 000 pas pour chaque cerveau : c'est une bonne première borne,
réglable par max_steps dans le yaml.
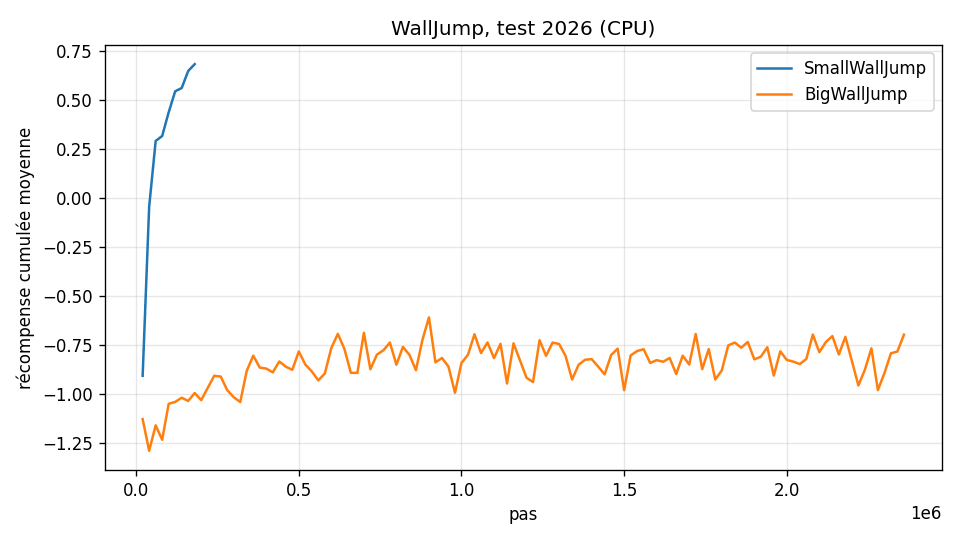
Dans TensorBoard (tensorboard --logdir results), il y a deux courbes de récompense, une par
cerveau : c'est la première chose à comprendre de cette activité.
3Activité 2 : les pyramides et la curiosité
Lecture recommandée : Diving deeper into Unity ML-Agents (Simonini, 2020, copie archivée).
L'agent ne reçoit de récompense qu'en prenant la brique d'or, au bout d'une longue chaîne d'actions : sans aide, il ne la trouve presque jamais. La curiosité ajoute une récompense intérieure : être surpris par ce qu'on voit. L'agent explore, et finit par tomber sur la brique.
- Scène
Assets/ML-Agents/Examples/Pyramids/Scenes/Pyramids, prefabAreaPB>Agent: vider Model. - Comparer
config/ppo/Pyramids.yaml(aveccuriositysousreward_signals) etconfig/ppo/PyramidsRND.yaml(une autre forme de curiosité, RND).
mlagents-learn config/ppo/Pyramids.yaml --run-id=pyramides1Mesuré avec ce guide : la récompense passe de -1 (la brique n'est jamais trouvée) à +1,05 en 1,5 million de pas (1 h 20 sur un portable à 4 coeurs sans carte graphique) ; elle devient positive vers 880 000 pas. Le yaml officiel prévoit 10 millions de pas : on peut s'arrêter bien avant.
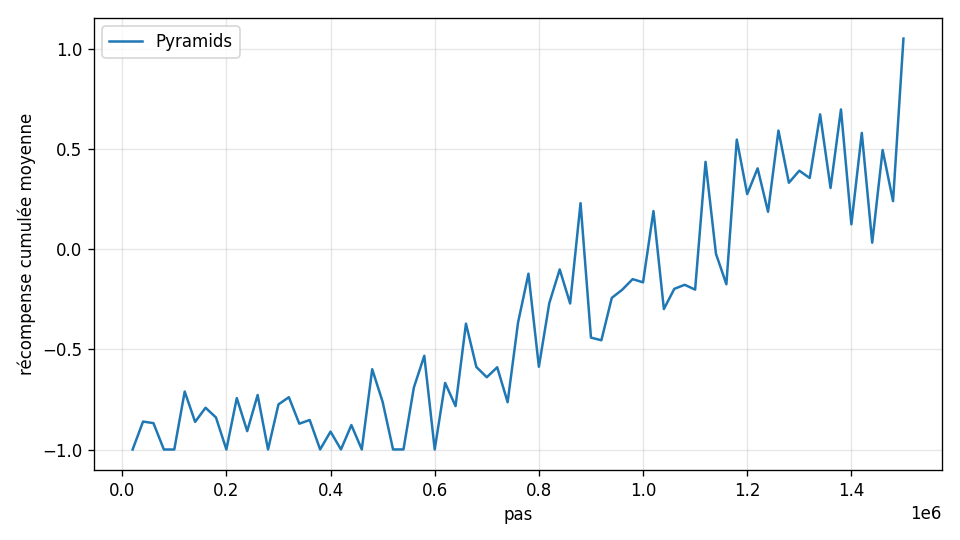
L'expérience qui fait comprendre : retirer le bloc curiosity du yaml, relancer avec un autre
--run-id, et comparer les deux courbes dans TensorBoard.
4Activité 3 : l'Aventure Maya 2026
Lecture recommandée : Unity ML-Agents : The Mayan Adventure (Simonini, 2020, copie archivée).
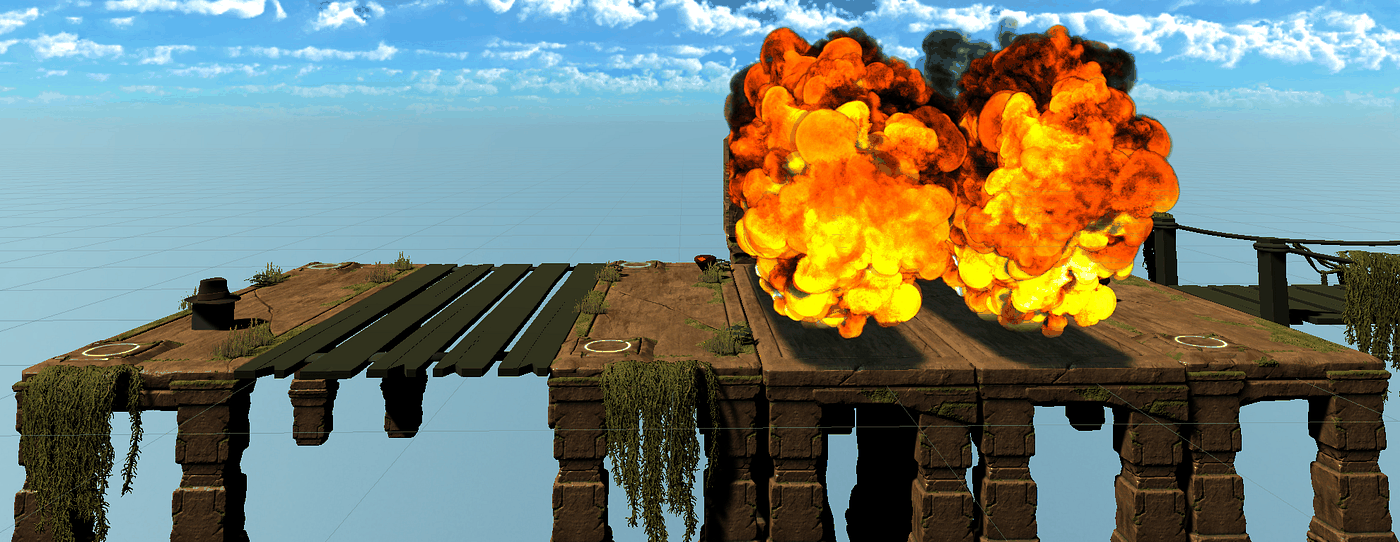
Ouvrir le projet dans Unity 6
- Télécharger the_mayan_adventure (Code > Download ZIP, 230 Mo).
- Avant de l'ouvrir, dans
The Mayan Adventure Unity Project/Packages/manifest.json, retirer les lignescom.unity.barracuda,com.unity.progrids,com.unity.collab-proxyetcom.unity.ide.vscode(ces paquets n'existent plus pour Unity 6), et mettre"com.unity.ml-agents": "4.0.3". SupprimerPackages/packages-lock.json. - Remplacer les scripts par leur version 2026 : temples-maya-code-2026.zip
(dossiers
Training Environmentetbeta, plus le yaml). Le code de 2021 ne compile plus. - Hub > Add project from disk > le dossier
The Mayan Adventure Unity Project, ouvrir avec 6000.3, accepter la mise à jour. Compter plusieurs minutes.
Attendu : la console n'affiche aucune erreur rouge. Un avertissement « No .NET SDKs were found » peut apparaître : il est sans effet.
Ce que le code 2026 change dans l'agent
    public override void OnActionReceived(ActionBuffers actions)
    {
        // Apply a tiny negative reward every step to encourage action
        AddReward(-1f / MaxStep);
        MoveAgent(actions.DiscreteActions);
        avanceeMaximale = Mathf.Max(avanceeMaximale, avanceeDansAire());
        recompenseCourante = GetCumulativeReward();
        pasCourant = StepCount;

        if (area.training)
        {
            // If fell of the platform (-1 neg reward)
            if(this.transform.position.y < 1.68f)
            {
                SetReward(-1f);
                noterFin("chute");
                base.EndEpisode();
            }
        }
        else if (area.training == false)
        {
            // If fell of the platform
            if(this.transform.position.y < -5)
            {
                StartCoroutine(GameOver());
            }
        }
} public override void Heuristic(in ActionBuffers actionsOut)
{
// 2026 : l'agent a des actions DISCRÈTES (3 branches de taille 3). Le code de 2021 écrivait dans
// ContinuousActions, qui est vide pour cet agent : le clavier ne faisait rien.
var discreteActionsOut = actionsOut.DiscreteActions;
discreteActionsOut[0] = 0;
discreteActionsOut[1] = 0;
discreteActionsOut[2] = 0;
#if ENABLE_INPUT_SYSTEM
var clavier = UnityEngine.InputSystem.Keyboard.current;
if (clavier == null) return;
if (clavier.wKey.isPressed) discreteActionsOut[0] = 1;
if (clavier.sKey.isPressed) discreteActionsOut[0] = 2;
if (clavier.aKey.isPressed) discreteActionsOut[2] = 1;
if (clavier.dKey.isPressed) discreteActionsOut[2] = 2;
#else
if (Input.GetKey(KeyCode.W)) discreteActionsOut[0] = 1;
if (Input.GetKey(KeyCode.S)) discreteActionsOut[0] = 2;
if (Input.GetKey(KeyCode.A)) discreteActionsOut[2] = 1;
if (Input.GetKey(KeyCode.D)) discreteActionsOut[2] = 2;
#endif
}Configurer l'entraînement (prefab Beta/MayanAdventureArea)
| Où | Valeur |
|---|---|
| Mayan Adventure Area | Training coché (sinon les animations de victoire et de chute ralentissent tout) |
| Agent > Behavior Parameters | Behavior Name MayanAdventureLearning ; Vector Observation 3, Stacked Vectors 6 ;
Actions : Continuous 0, Discrete Branches 3, chaque branche de taille 3 ; Model vide ; Behavior Type Default |
| Agent > Mayan Adventure Agent | Max Step 5000 |
| Agent > Decision Requester | Decision Period 5 |
| Les deux Ray Perception Sensor 3D | 3 rayons par direction, 70 degrés, Sphere Cast Radius 0,5, Ray Length 30,
Observation Stacks 6 ; tags : safeSpot, ToRockButton, ToWoodButton, fireOn, fireOff, woodBridge, rotateWoodBridge, goal, gem ;
le second ajoute void (le vide, pour apprendre à ne pas tomber) et End Vertical Offset -1 |
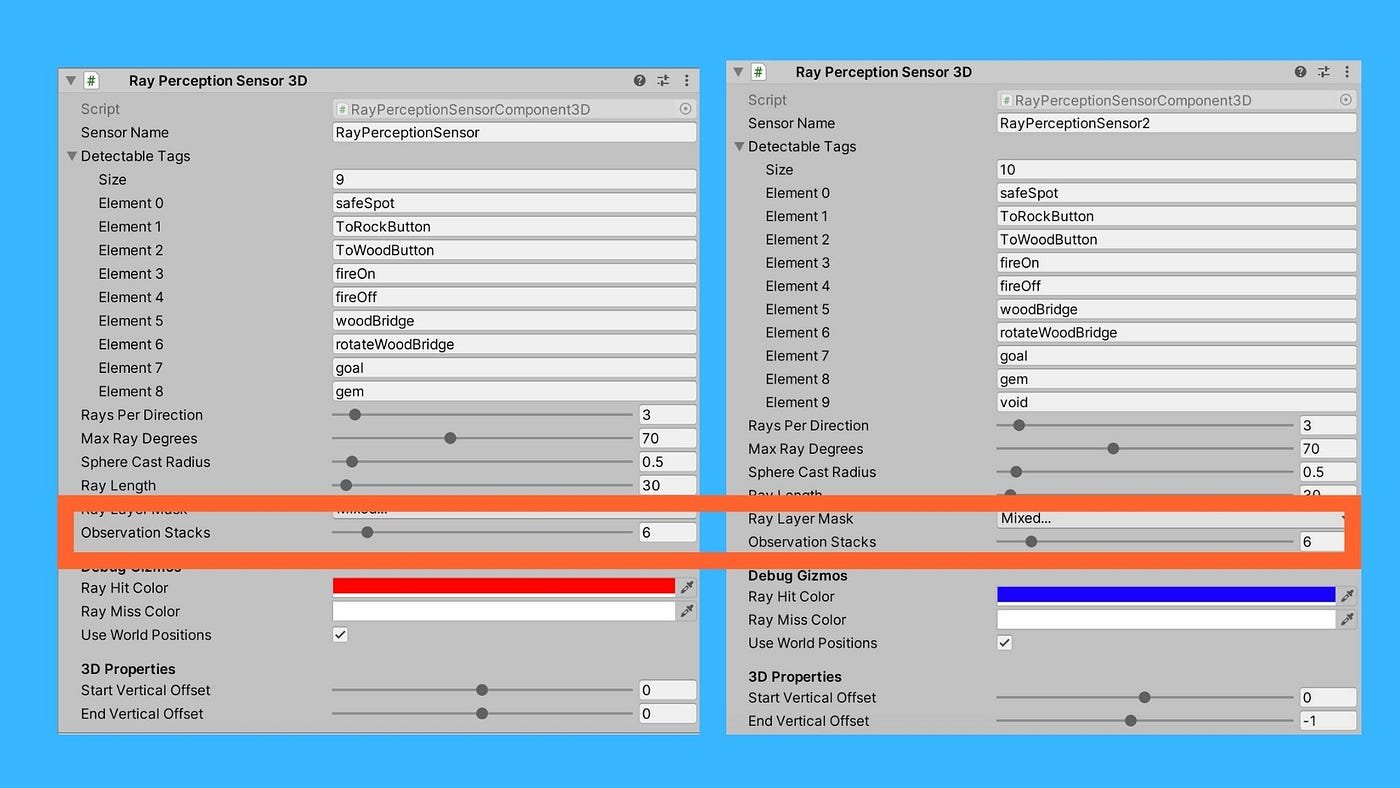
La scène Beta contient 32 copies de l'aire : 32 Indie apprennent en même temps avec le même cerveau.
Le fichier de configuration et le curriculum
Le dépôt ne contient aucun yaml : celui-ci est reconstitué à partir des images de l'article et réécrit au format
de la Release 23. La section environment_parameters est le curriculum : le paramètre
level (lu par MayanAdventureArea.cs) passe de 0 à 3 quand la récompense moyenne dépasse 0,8,
puis 1,6, puis 2,2.
behaviors:
  MayanAdventureLearning:
    trainer_type: ppo
    hyperparameters:
      batch_size: 1024
      buffer_size: 2048
      learning_rate: 1.0e-4
      beta: 1.0e-2
      epsilon: 0.2
      lambd: 0.95
      num_epoch: 8
      learning_rate_schedule: constant
    network_settings:
      normalize: true
      hidden_units: 512
      num_layers: 2
      vis_encode_type: simple
    reward_signals:
      extrinsic:
        gamma: 0.99
        strength: 1.0
      curiosity:
        gamma: 0.99
        strength: 0.02
        network_settings:
          hidden_units: 256
        learning_rate: 3.0e-4
    time_horizon: 1000
    max_steps: 5.0e6
    summary_freq: 30000
    checkpoint_interval: 500000
    threaded: true

environment_parameters:
  level:
    curriculum:
      - name: Niveau0Statue
        completion_criteria:
          measure: reward
          behavior: MayanAdventureLearning
          signal_smoothing: true
          min_lesson_length: 100
          threshold: 0.8
        value: 0.0
      - name: Niveau1GrandPontDeBois
        completion_criteria:
          measure: reward
          behavior: MayanAdventureLearning
          signal_smoothing: true
          min_lesson_length: 100
          threshold: 1.6
        value: 1.0
      - name: Niveau2Feu
        completion_criteria:
          measure: reward
          behavior: MayanAdventureLearning
          signal_smoothing: true
          min_lesson_length: 100
          threshold: 2.2
        value: 2.0
      - name: Niveau3PetitPontDeBois
value: 3.0# à la racine du projet Unity (où se trouve le dossier config)
mlagents-learn config/MayanAdventureLearning.yaml --run-id=maya1
# puis PlayMesuré avec ce guide : avec la récompense du bon bouton (section suivante), niveau 2 au pas 120 000, niveau 3 (le temple complet) au pas 1,1 million, puis 79 % de parcours réussis ; 3 millions de pas en 3 h 04 sur un portable à 4 coeurs sans carte graphique, 32 aires, en repartant d'un premier cerveau. Sans cette récompense, notre premier entraînement est resté bloqué au niveau 2 pendant 2,3 millions de pas. L'article de 2020 parlait de 2 h 10 sur un portable, sans carte graphique, avec 30 environnements. Dans TensorBoard, la courbe Environment / Lesson montre le passage d'un niveau à l'autre.
Quand Indie n'ose plus avancer
Voici notre premier entraînement, fait exactement comme ci-dessus. Les niveaux 0 et 1 passent vite. Puis, au niveau 2, la récompense s'effondre et ne remonte plus jamais, pendant 2,3 millions de pas.
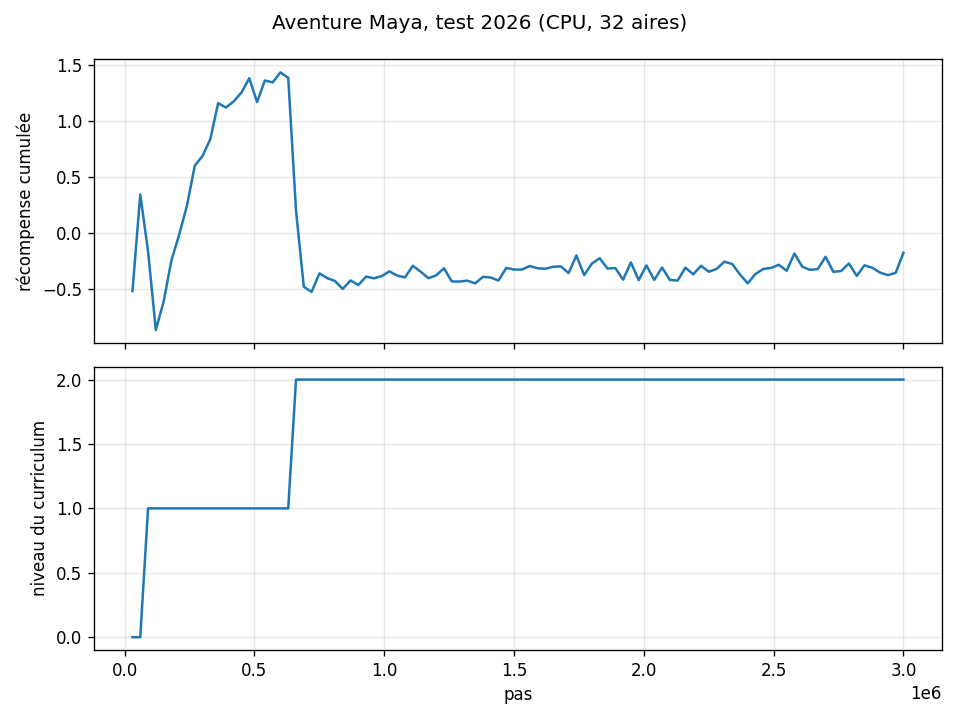
À vous de jouer, avant de lire la suite : qu'est-ce qui change entre le niveau 1 et le niveau 2 ? Où sont les boutons, et pour quel obstacle servent-ils ? Que doit faire Indie, dans l'ordre, pour franchir le feu ? Quand reçoit-il sa première récompense après avoir fait le bon geste ?
Ce que le journal de l'agent révèle
Le code 2026 peut écrire chaque fin d'épisode dans le journal du lecteur (paramètre d'environnement
diagnostic: 1.0 dans le yaml ; lignes [DiagnosticMaya] dans
results/<run-id>/run_logs/Player-0.log). Sur 491 épisodes joués par le cerveau bloqué :
- Aucun but atteint.
- 46 % : le temps s'écoule. Indie prend la gemme, puis tourne en bois autour du grand pont sans entrer dans le feu.
- 12 % : mort dans le feu, en bois, à l'entrée. Aucun de ces agents n'avait touché le bouton roche.
- Le bouton roche n'est trouvé que dans 17 % des épisodes, et Indie gâche aussitôt sa chance : il revient sur les planches en roche, ou tombe du bord (le bouton est à une unité du vide).
La clé est dans la construction des niveaux : chaque plateforme porte les boutons de l'obstacle suivant. Pour franchir le feu, Indie doit, juste après le pont, faire un détour à droite vers le bouton roche (le contraire de ce que le niveau 1 lui a appris : aller à gauche vers le bouton bois), puis traverser 20 unités de feu. Le seul signal positif arrive au but, 40 unités plus loin. Rien ne lui dit que le détour était le bon geste.
Le remède : récompenser le bon bouton
Le code 2026 contient une récompense de plus, désactivée par défaut (le jeu reste celui de 2020) : quand un bouton donne à Indie la forme que demande l'obstacle suivant, il reçoit +0,1, une seule fois par bouton et par épisode (sinon il apprendrait à faire des allers-retours entre deux boutons pour accumuler des points).
    // 2026 : récompense du bon bouton. Avec le paramètre d'environnement « recompenseBonBouton » (0 par défaut = jeu
    // d'origine), l'agent reçoit cette récompense quand un bouton lui donne la forme que demande l'obstacle suivant,
    // une seule fois par bouton et par épisode (pas de va-et-vient payant entre deux boutons).
    HashSet<int> boutonsRecompenses = new HashSet<int>();

    void recompenserBouton(GameObject bouton, MayanAdventureArea.FormeAttendue formeDonnee, bool formeChange)
    {
        var recompense = Academy.Instance.EnvironmentParameters.GetWithDefault("recompenseBonBouton", 0f);
        if (recompense <= 0f || !formeChange || !area.training) return;
        if (area.formeAttendueApres(bouton.transform) != formeDonnee) return;
        if (!boutonsRecompenses.Add(bouton.GetInstanceID())) return;
        AddReward(recompense);
} /// <summary>
/// 2026 : forme que demande l'obstacle qui suit ce bouton. Un bouton du niveau de départ précède le premier niveau
/// généré ; un bouton du niveau généré numéro n précède le niveau n + 1 ; après le dernier, il n'y a que le but.
/// </summary>
public FormeAttendue formeAttendueApres(Transform bouton)
{
int indiceSuivant = 0;
for (int indice = 0; indice < niveauxGeneres.Count; indice++)
{
if (niveauxGeneres[indice] != null && bouton.IsChildOf(niveauxGeneres[indice].transform))
{
indiceSuivant = indice + 1;
}
}
if (indiceSuivant >= modelesGeneres.Count)
{
return FormeAttendue.Aucune;
}
return modelesGeneres[indiceSuivant] == fireLevel ? FormeAttendue.Pierre : FormeAttendue.Bois;
}Le yaml config/MayanAdventureLearning-bon-bouton.yaml du zip active cette récompense
(recompenseBonBouton: 0.1) et relève les seuils du curriculum de 0,1 par bouton utile
(1,6 devient 1,7 ; 2,2 devient 2,4).
# repartir des poids de maya1 (les niveaux 0 et 1 sont déjà appris)
mlagents-learn config/MayanAdventureLearning-bon-bouton.yaml --run-id=maya2 --initialize-from=maya1
# puis Play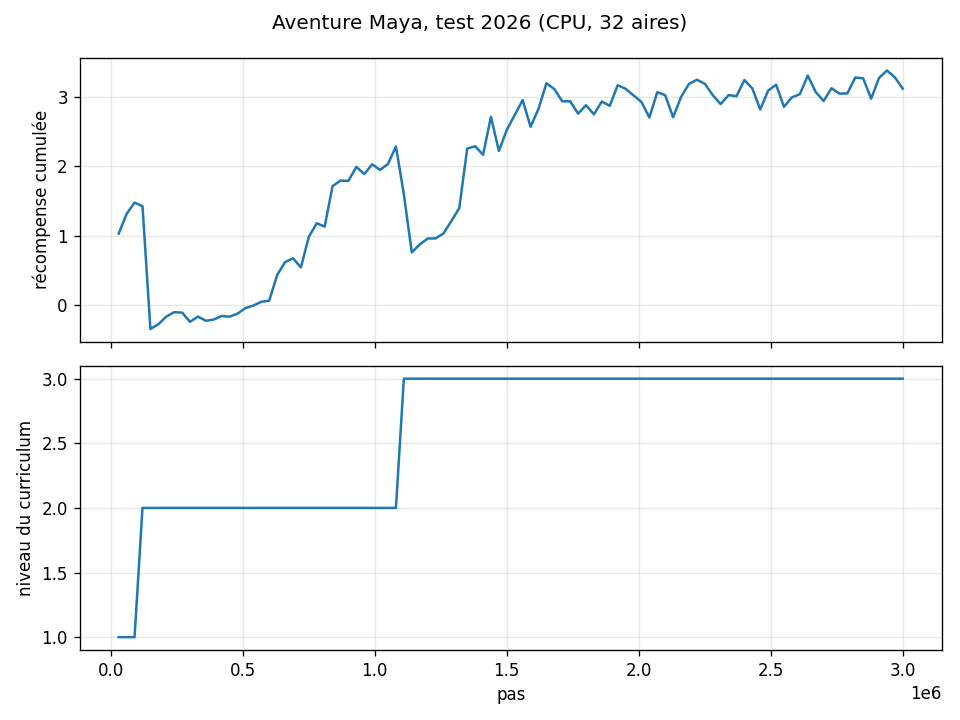
Mesuré : sur les 500 derniers épisodes, au niveau 3, 79 % de parcours réussis (contre 0 % au niveau 2 sans la récompense), 363 avec les trois gemmes, et le bouton roche trouvé 448 fois.
⚖️ La notion que vous venez de rencontrer : l'attribution du mérite (credit assignment). Quand la récompense arrive longtemps après le geste qui l'a rendue possible, l'agent ne sait pas quel geste remercier. Ajouter une petite récompense sur une étape intermédiaire s'appelle façonner la récompense (reward shaping) : efficace, mais à doser, car l'agent optimise exactement ce qu'on récompense, y compris ce qu'on n'avait pas prévu.
Rejouer avec son cerveau
- Copier
results/maya1/MayanAdventureLearning.onnxdansAssets. - Dans le prefab : Training décoché ; Behavior Parameters > Model = le
.onnx. - Dans la scène, ne garder qu'une seule aire active (les autres décochées) et réactiver la Main Camera. Avec ML-Agents 4.0.3, un seul agent par cerveau reçoit ses actions en inférence : une aire suffit de toute façon.
- Play : Indie traverse, se transforme et prend la statue.
Piège : si Indie reste immobile en Play, vérifier dans Behavior Parameters que
Model contient bien le .onnx et que Behavior Type n'est plus Default : sans cerveau et sans
entraîneur, l'agent attend des actions qui ne viennent jamais.
5Remise
- Pour chaque activité : le fichier de configuration
yamlutilisé. - Pour chaque activité : le répertoire
results/<run-id>(cerveaux.onnxet journaux TensorBoard). - Une capture TensorBoard par activité ; pour Maya, aussi la courbe Environment / Lesson.
6Dépannage
| Symptôme | Cause et remède |
|---|---|
No module named 'pkg_resources' | pip install "setuptools<81" dans le venv. |
| Le projet Maya refuse d'ouvrir ou réclame Barracuda | Le manifest.json n'a pas été nettoyé (section 4), ou packages-lock.json est resté. |
error CS0115 sur OnActionReceived(float[]) | Les scripts de 2021 sont encore là : les remplacer par ceux du zip 2026. |
| Le clavier ne fait rien en Heuristic Only (Maya) | Bogue du code d'origine (actions continues au lieu de discrètes) : corrigé dans la version 2026. |
Les cerveaux .nn fournis n'entrent pas dans le champ Model | Format Barracuda, illisible par Inference Engine : réentraîner pour obtenir un .onnx. |
| Maya : Lesson bloquée à 2, récompense autour de -0,3 | Indie n'apprend pas à prendre le bouton roche avant le feu : utiliser MayanAdventureLearning-bon-bouton.yaml (section 4, « Quand Indie n'ose plus avancer »). |
| Le niveau ne monte jamais (Environment / Lesson reste à 0) | Le Behavior Name doit être exactement MayanAdventureLearning, comme dans le yaml. |
| Tout est rose ou hachuré dans la scène | Unity 6 compile les shaders : patienter. Si ça reste rose, Window > Rendering > Render Pipeline Converter. |
| Un lecteur construit sous Linux ne se connecte pas à l'entraîneur | Copier libgrpc_csharp_ext.x64.so de Plugins/AnyCPU/ vers Plugins/x86_64/. |
Retour à l'énoncé du labo Temples Maya · intro : Aventure Maya, un projet ML-Agent · assets : The Mayan Adventure (Thomas Simonini, 2021) · doc : ML-Agents 4.0.